TalentCLEF 2026 대회 우승 회고

안녕하세요, CLASSUM에서 기술개발총괄을 맡고있는 김상근(Windy)입니다.
CLASSUM은 대학과 기업을 위한 학습 플랫폼 Learning과 학사/입학/진로 취업 상담 AI 챗봇 Connect를 만들고 있습니다. 이 글에서는 올해 참가한 TalentCLEF 2026 대회의 소개와, 두 태스크를 풀면서 만난 문제 및 해결방법에 대해 공유하려고 합니다. 이 기술을 진로 취업 상담 챗봇에 어떻게 적용할 수 있는지도 같이 알아봅니다.
대회 결과
Task A, Task B 두 태스크 모두 1위를 했습니다.

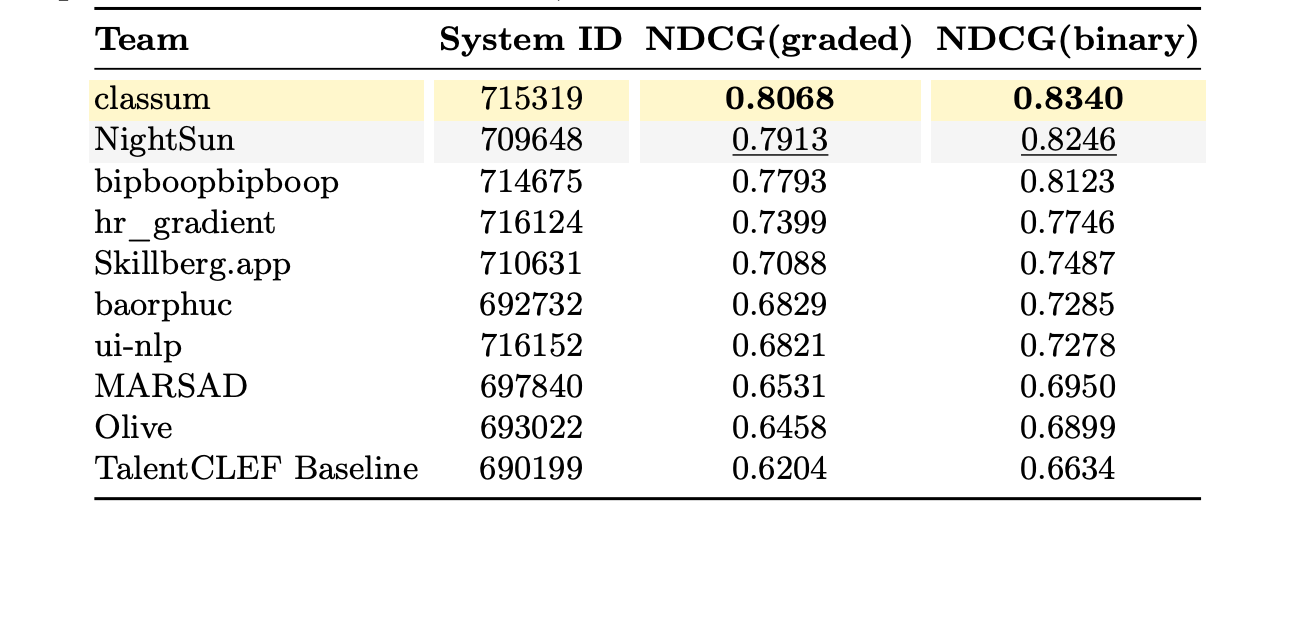
우리 팀의 자세한 알고리즘은 CLEF 2026 Working Notes(CEUR-WS Vol-4283)에 실렸습니다.
TalentCLEF 2026
TalentCLEF는 채용, 직무, 스킬 같은 HR 분야의 자연어처리 문제를 다루는 대회로, CLEF 2026의 Lab으로 열렸습니다. 올해가 두 번째이고, 113팀이 등록해 400건이 넘는 제출이 있었습니다. 대회 초반에 정답이 있는 dev dataset이 주어지고, 대회 후반에 정답이 없는 test dataset이 공개됩니다.
Task A: 직무-이력서 매칭
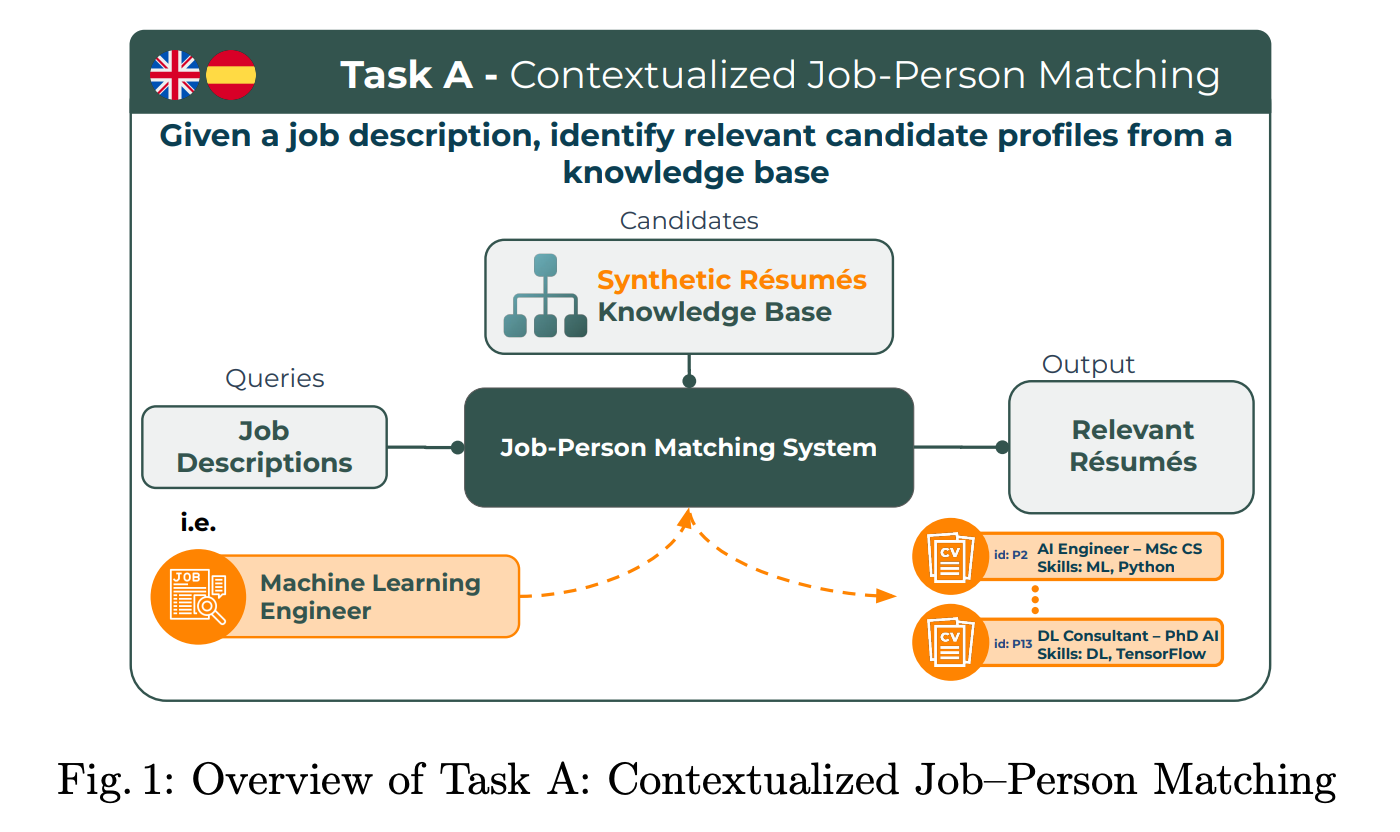
채용공고(JD) 하나가 주어지면 이력서 N개를 적합한 순서로 정렬하는 문제입니다. 영어와 스페인어가 있고, 영어 공고로 스페인어 이력서를 찾는 cross-lingual 태스크도 따로 평가합니다. 평가 지표는 MAP입니다.
MAP (Mean Average Precision): 쿼리마다 관련 문서가 나올 때마다의 정밀도를 평균(AP)하고, 이것을 전체 쿼리에 대해 다시 평균한 값으로, 관련 문서를 얼마나 앞쪽에 모아 두었는지를 이진 관련성 기준으로 봅니다.
Task B: 직무-스킬 매칭
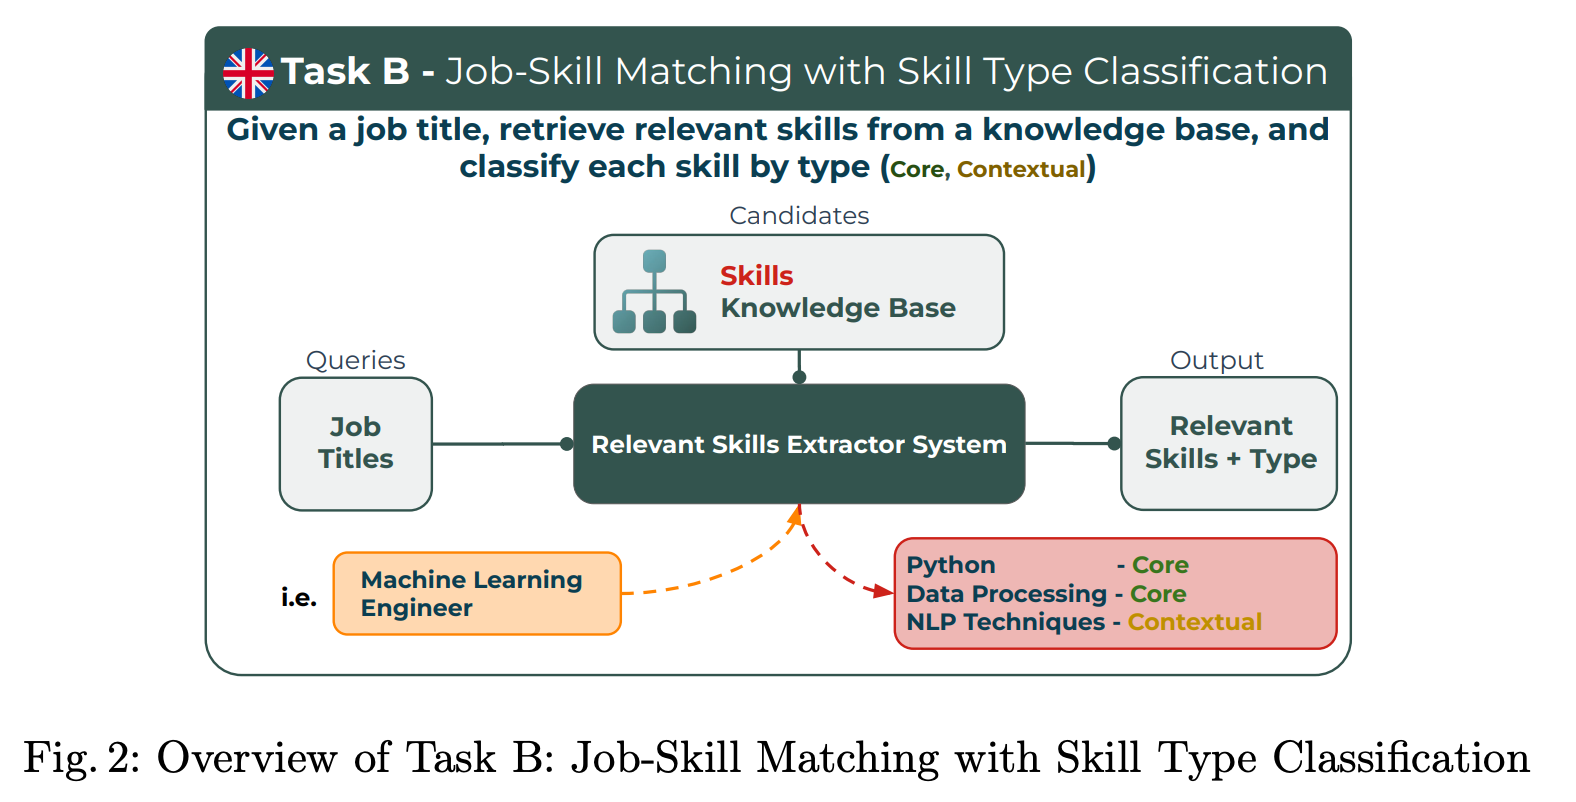
"logistics business analyst" 같은 직무명이 주어지면, 유럽의 직무·스킬 분류 체계인 ESCO의 스킬 수천 개 중 관련 있는 것을 찾아 정렬하는 문제입니다. 그 직무에 꼭 필요한 Core 스킬을 상황에 따라 필요한 Contextual 스킬보다 앞 순위에 정렬할수록 좋은 점수를 받습니다. 평가 지표는 graded NDCG입니다. Task A와 달리 학습 데이터가 주어집니다.
nDCG (normalized Discounted Cumulative Gain): 등급형 관련도 점수를 순위가 내려갈수록 로그로 깎아 합산(DCG)한 뒤, 이상적인 순서일 때의 값(IDCG)으로 나눠 0~1로 정규화한 지표입니다.
Problem
dev dataset을 받고 가장 먼저 원문을 그대로 임베딩한 뒤 코사인 유사도로 정렬해 채점해봤습니다. 두 태스크 모두 결과가 좋지 않았고, 원인은 서로 달랐습니다.
Task A는 채용공고(JD)와 이력서를 JobBERT-v3 모델로 임베딩했고, dev MAP이 0.7281이었습니다. 겉으로 겹치는 단어가 문제였습니다. “Healthcare Data Analyst” 공고와 “Electrical Engineer” 이력서는 engineering, data, systems 같은 단어를 공유하지만 하는 일은 전혀 다릅니다.
Task B는 직무명과 스킬을 MiniLM-L6-v2 모델로 임베딩했고, dev graded NDCG가 0.6107이었습니다. 여기서는 반대로 입력이 너무 짧은 것이 문제였습니다. 직무명은 두세 단어이고 스킬 이름도 한 줄이라 겹칠 것이 거의 없습니다.
또한 이 대회는 리더보드가 비공개였습니다. 제출해도 다른 팀의 점수를 볼 수 없고 완벽한 블라인드 상태에서 대회를 진행하다 보니, 우리 팀의 실험 결과가 어느 정도 위치에 있는지 알 수 없다는 문제도 있었습니다. (대회 기간 내내 쫓기는 듯한 느낌을 받았습니다.)
Solution, Task A: 직무-이력서 매칭
Approach 1. 원문 임베딩
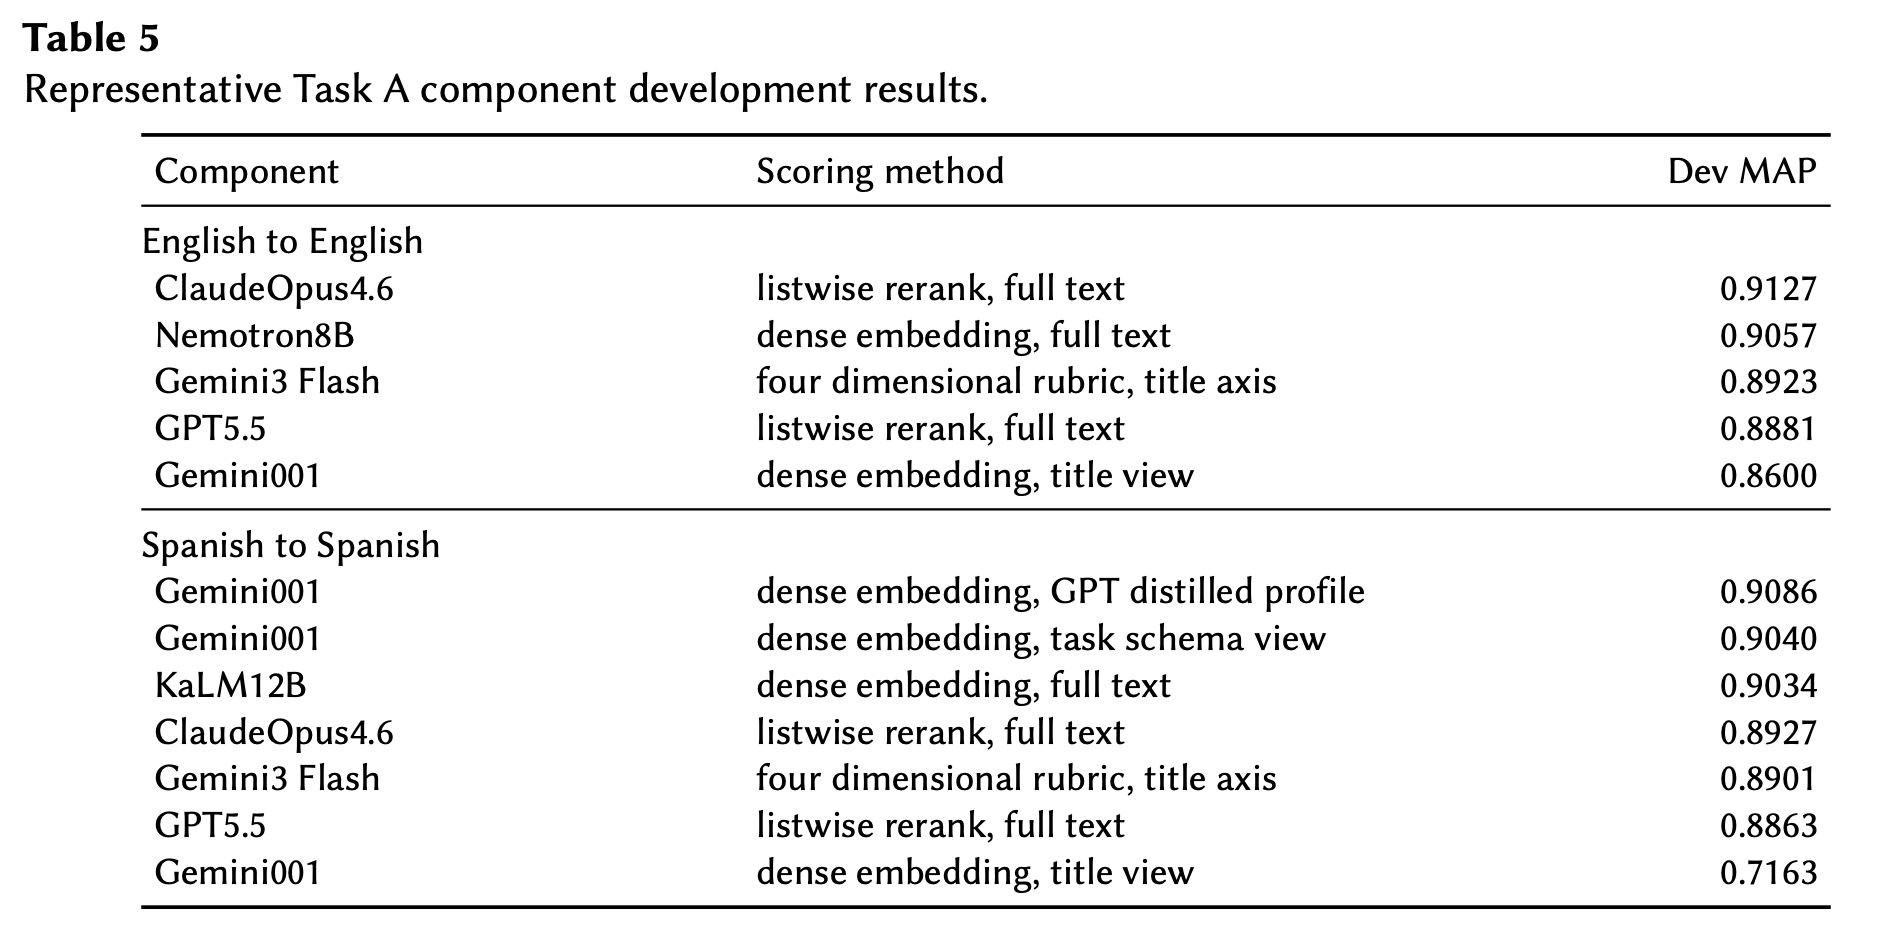
임베딩 모델을 더 크고 성능이 좋은 범용 모델로 바꾸자 모델 하나만으로도 dev MAP이 0.90 정도 나왔습니다. 하지만 단어만 겹치는 이력서가 상위에 올라오는 문제가 있었고, 임베딩 모델을 다양하게 실험해봐도 점수가 더 오르지 않았습니다.
Approach 2. LLM을 이용한 프로필 확장
공고와 이력서를 LLM을 활용하여 같은 구조에 맞춰 다시 썼습니다. 직함, 연차, 도메인, 세부 분야, 요약을 뽑고, 스킬(할 수 있는 것)과 업무(실제로 한 것)를 나눠 추출했습니다. 스킬은 다시 그 직무에 특화된 것과 다른 직무에도 통하는 것으로 구분했습니다.
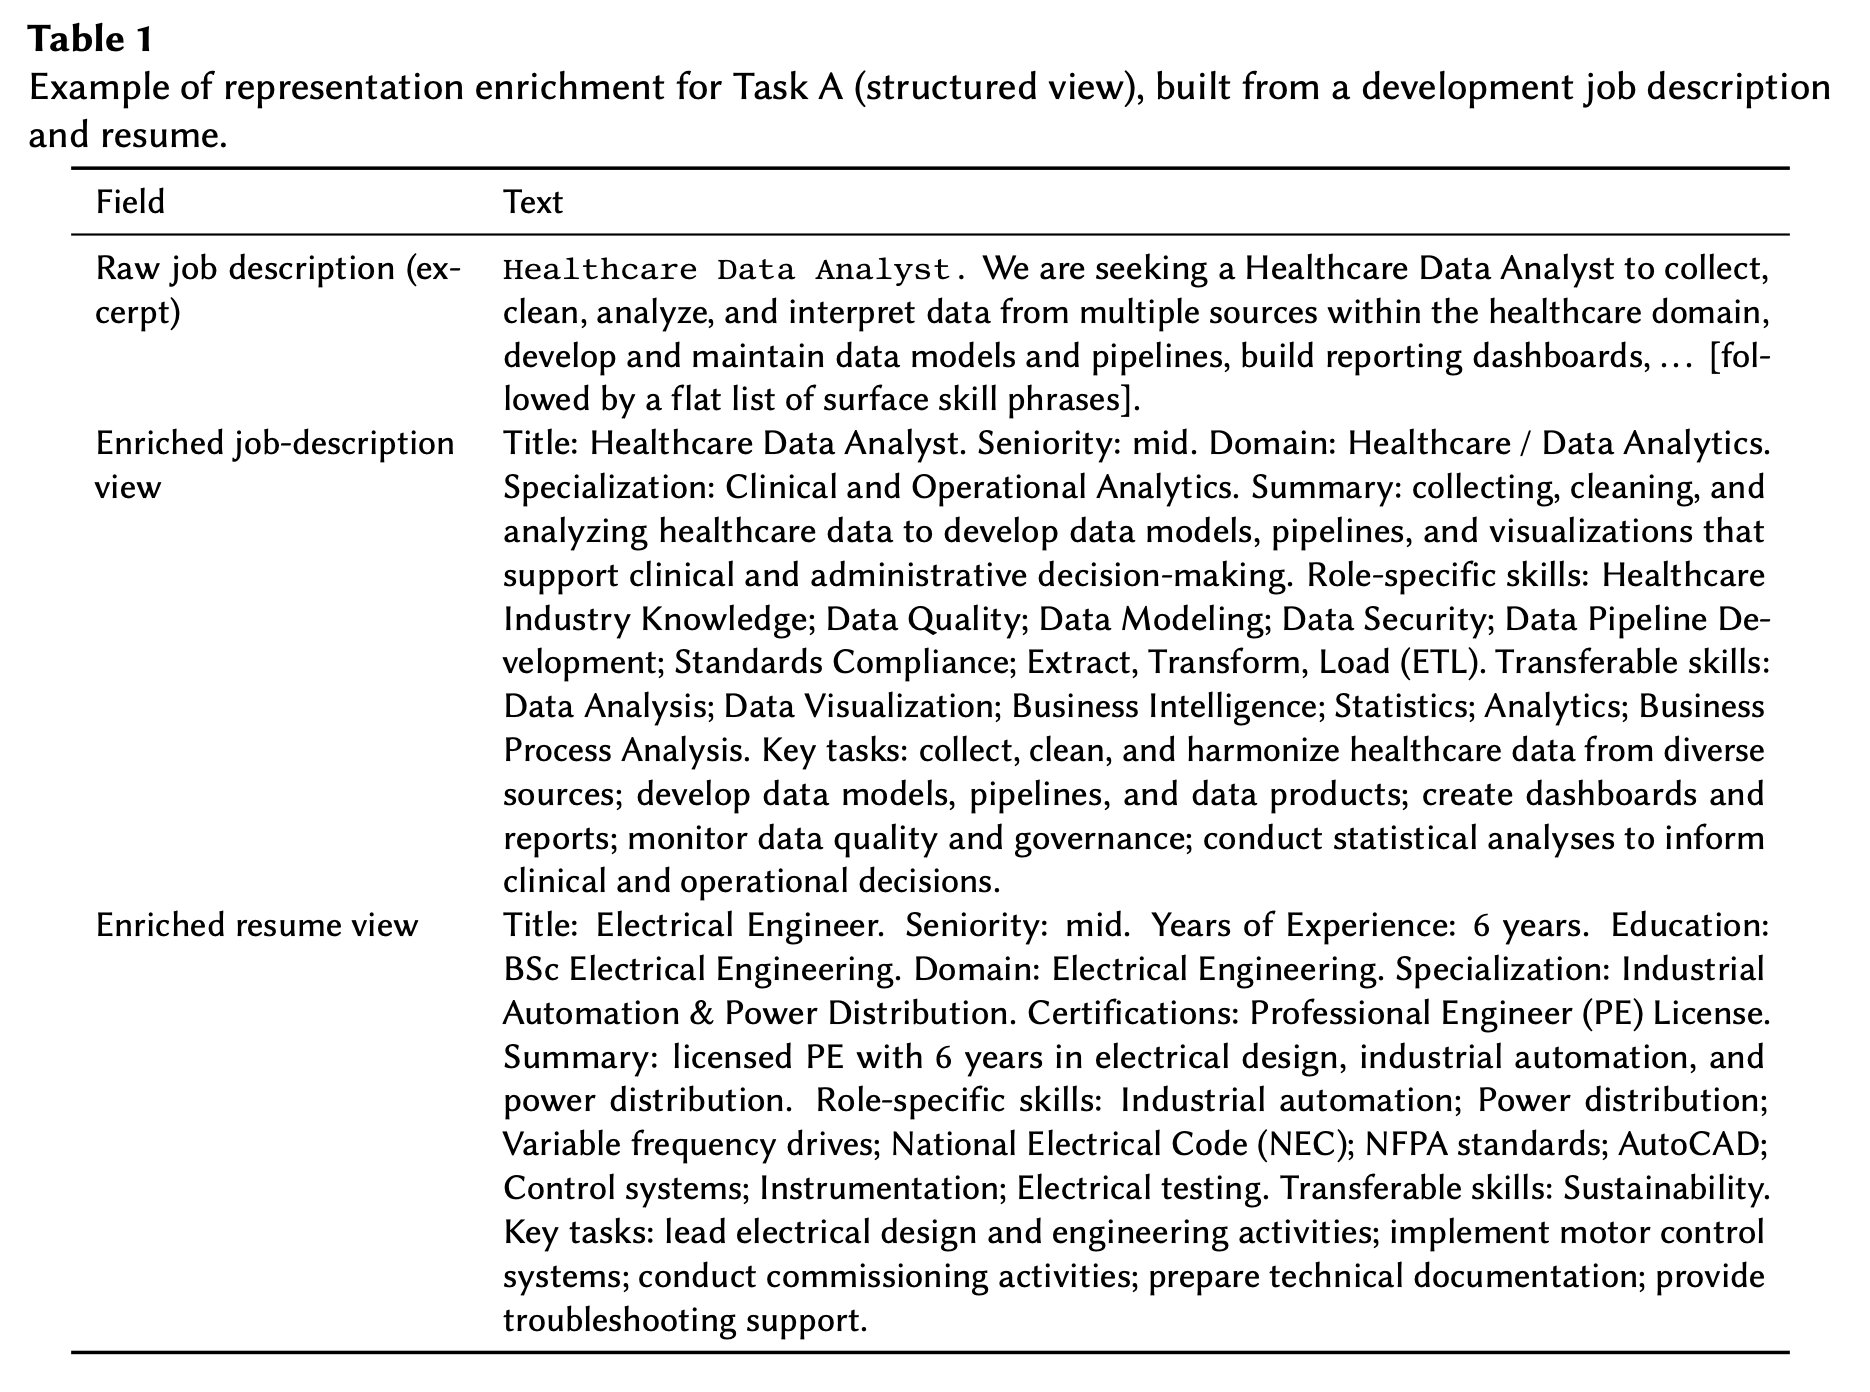
이렇게 하면 그림 6의 “Healthcare Data Analyst” 공고와 “Electrical Engineer” 이력서는 도메인 항목에서 “Healthcare / Data Analytics”와 “Electrical Engineering”으로 바로 구분됩니다. 확장한 프로필은 전체를 임베딩하기도 하고, 직함만 또는 업무 목록만 따로 임베딩하기도 했습니다.
Approach 3. 모델 앙상블
단일 모델로는 한계가 있어서 성격이 다른 채점 모델을 18개 정도 만들었습니다.
- 원문 임베딩 (Nemotron-8B, KaLM-12B, ZEmbed-1 등)
- 확장한 프로필 임베딩 (Gemini embedding)
- LLM에게 이력서를 한꺼번에 주고 순위를 매기게 하는 listwise 채점 (GPT-5.5, Claude Opus 4.6)
- 직함, 연차, 직능, 도메인 네 차원으로 점수를 매기는 루브릭 채점 (Gemini 3 Flash)
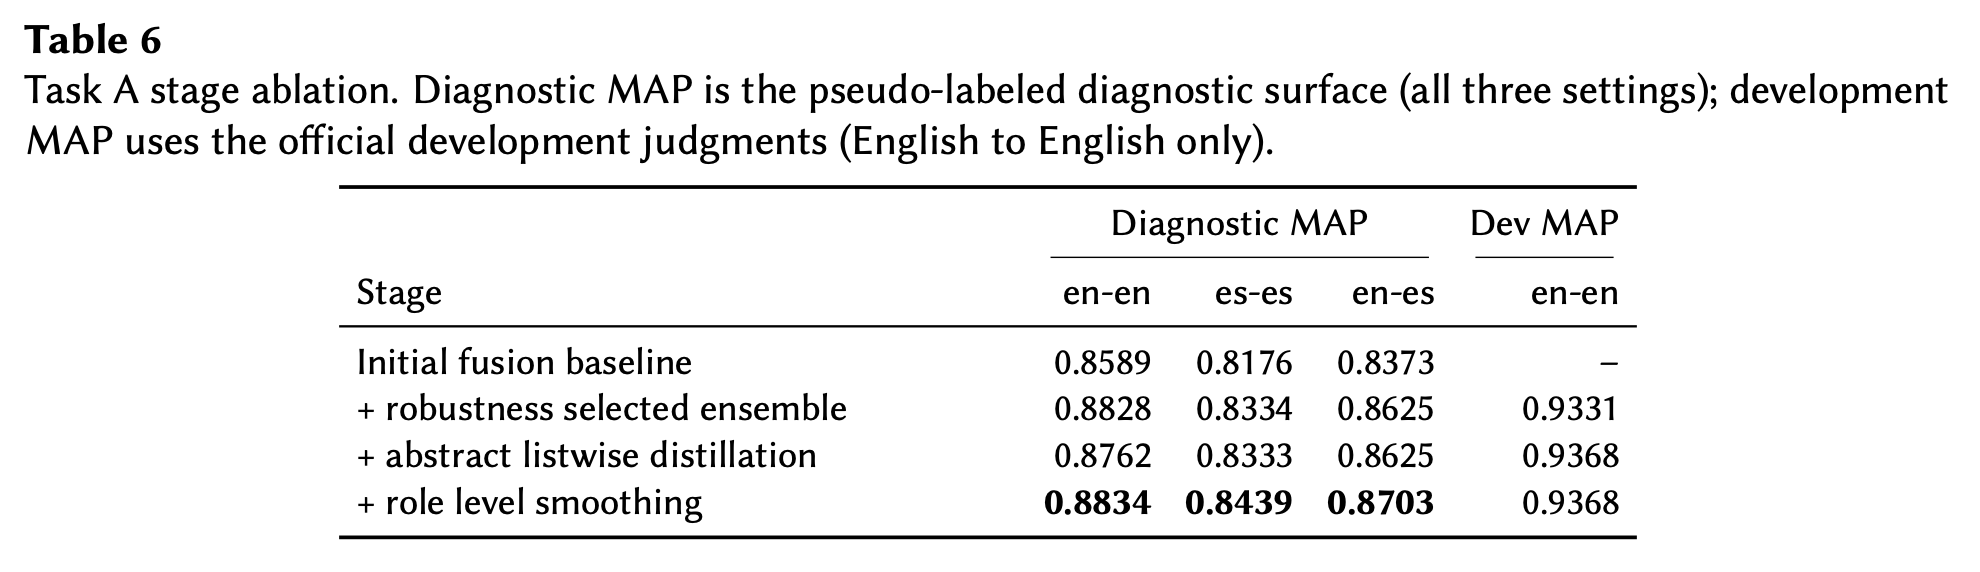
각 모델의 점수는 공고 단위로 0~1 사이로 정규화한 뒤 더했습니다. 성능이 좋은 모델에 가중치를 더 주는 방법(선형, 제곱, 세제곱, 지수, 순위 기반)도 해봤지만, 전부 가중치를 똑같이 준 것보다 낮았습니다. 이 접근으로 dev MAP 0.9339점을 얻었습니다.
Approach 4. dev 정답 기반 매칭 기준 추출
dev dataset의 정답은 사람이 직접 검수한 것입니다. 그래서 공고마다 정답 이력서와, 비슷해 보이지만 오답인 이력서를 묶어 LLM에게 주고 채점자의 판단 기준을 정리하게 했습니다.
처음에는 "계산원은 판매직에 합격" 같이 특정 직무명에 묶인 규칙이 나와서 쓸 수가 없었습니다. 직무명 대신 일의 종류로 쓰도록 프롬프트를 변경한 뒤에는 "같은 도구를 써도 그 도구로 하는 일이 다르면 맞지 않는다" 같은 기준이 나왔고, 이를 listwise 채점과 루브릭 채점의 지시문에 넣었습니다. 이 접근으로 dev MAP 0.9368점을 얻었습니다.
Approach 5. 앙상블 조합 선택
실험 결과는 전부 파일로 저장해 두었기 때문에, 모델 18개로 만들 수 있는 약 26만 개의 조합을 계산만으로 비교할 수 있었습니다. 문제는 기준이었습니다. dev 점수가 가장 높은 조합을 고르면 dev에만 맞춰질 위험이 컸습니다. 실제로 dev MAP 0.93대 조합의 첫 test 제출 점수는 0.69였습니다.
그래서 기준을 하나 더 만들었습니다. 사내에서 쓰던 스킬/업무 추출 파이프라인으로 공고와 이력서의 프로필을 만들고, 프로필이 겹치는 정도로 내부 평가용 정답 셋을 만들었습니다. 그리고 dev 점수와 내부 정답 셋 점수 중 낮은 쪽이 가장 높은 조합을 골랐습니다. 세부 태스크인 언어 설정(영어-영어, 스페인어-스페인어, 영어-스페인어)마다 조합도 따로 골랐습니다.
Approach 6. 후처리
test dataset을 직접 읽어 보니 같은 역할의 이력서가 표현만 바뀌어 여러 개 들어 있었습니다. 따라서 같은 역할로 묶이는 이력서끼리 점수를 평균 내어 다시 나눠 주었습니다.
또한 합친 점수를 정렬해 보면 점수가 거의 같은 이력서들이 모여 plateau를 이룹니다. 이 plateau를 찾은 뒤, 각 plateau 안에서만 reranker(zerank-2)로 순서를 다시 정했습니다. plateau 사이의 순서는 바꾸지 않았고, 이 접근으로 최종 test MAP 0.7140점을 받았습니다.
Algorithm pseudo code
function rank(jd, cvs, lang):
  scores := []
  for scorer in SELECTED[lang]:                 # Approach 5
    s := scorer.score(enrich(jd), enrich(cvs))  # Approach 2, 4
    scores.push(minmax(s))                      # 공고 단위 정규화
  fused := sum(scores)                          # Approach 3
  fused := smoothByRole(fused, cvs)             # Approach 6
  fused := rerankWithinPlateau(fused)           # Approach 6
  return sortBy(cvs, fused)
Bias 평가
Task A는 성별 편향도 따로 평가합니다. 이름과 직함의 성별 표현만 바꾼 이력서를 넣었을 때 순위가 얼마나 유지되는지를 RBO로 측정합니다.
RBO (Rank-Biased Overlap): 두 순위 리스트가 각 깊이에서 얼마나 겹치는지를 상위에 더 큰 가중치(파라미터 p)를 두고 합산한 유사도로, 정답 없이 두 랭킹이 서로 얼마나 비슷한지 비교할 때 씁니다.
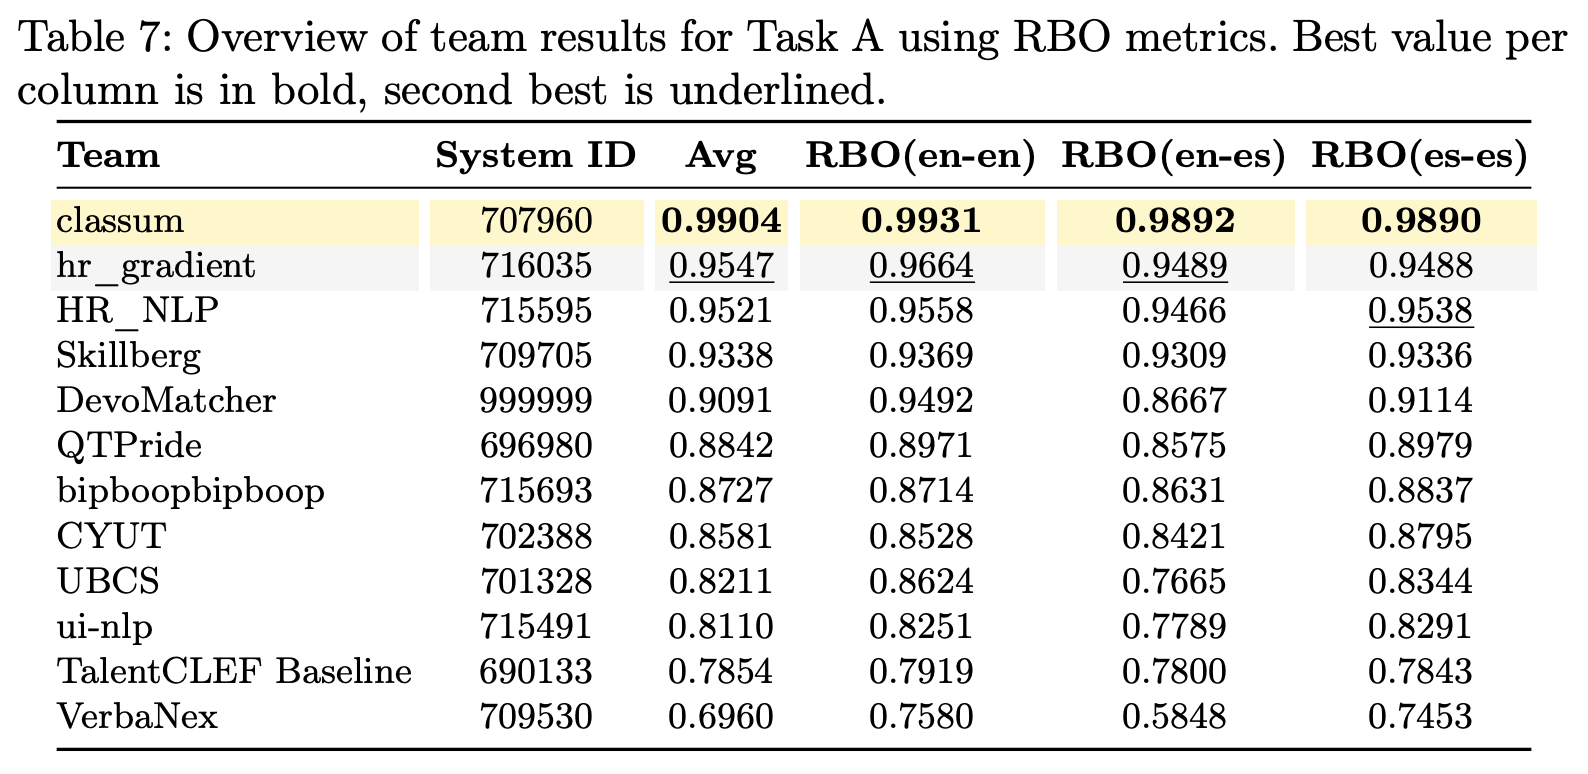
평균 RBO 0.9904로 이 평가에서도 1위였습니다(2위 0.9547). 편향을 줄이는 장치를 따로 넣지는 않았는데, 주최 측은 스킬과 업무 중심으로 프로필을 확장하면서 이름이나 성별 표현의 영향이 줄었을 것이라고 해석했습니다.
Solution, Task B: 직무-스킬 매칭
Approach 1. 직무명과 스킬 확장
Task A와 같은 생각으로, 직무명과 스킬을 둘 다 확장했습니다. 직무명은 LLM으로 그 직무가 하는 업무와 필요한 스킬 목록으로 확장했습니다. 스킬은 ESCO에 있는 정보(다른 이름, 설명, 상위 개념, 연결된 직업)를 붙여 스킬마다 카드를 만들었습니다.

아래는 같은 임베딩 모델에서 입력만 바꿔 비교한 결과입니다.
직무명스킬graded NDCG원문원문0.6745원문스킬 카드0.7094확장한 프로필스킬 카드0.7555
Approach 2. 임베딩 모델 파인튜닝
Task B는 학습 데이터가 있어서 오픈웨이트 임베딩 모델 네 개(ZEmbed-1, KaLM-Embedding-Gemma3-12B, Qwen3-Embedding-8B, Llama-NV-Embed-Reasoning-3B)를 파인튜닝했습니다.
여기서 문제는 오답 처리였습니다. Contrastive learning은 같은 배치 안의 다른 스킬을 오답으로 취급하는데, ESCO 스킬은 서로 비슷한 것이 많아서 오답으로 처리된 스킬이 사실은 정답에 가까운 경우가 많았습니다. 그래서 먼저 학습한 모델을 guide로 두고, guide가 보기에 정답과 점수 차이가 거의 없는 후보는 오답에서 제외하고 학습했습니다. 이 접근으로 모델별 dev graded NDCG 0.7792 ~ 0.7894가 나왔습니다.
Approach 3. 앙상블과 reranking
네 모델의 점수를 가중합으로 합쳤습니다. 가중치는 dev dataset에서 Optuna로 탐색했습니다. 마지막으로 상위 512개를 zerank-2로 rerank한 뒤 원래 점수와 절반씩 섞었고, dev graded NDCG 0.8078 점수를 얻었습니다.
Task B는 test 점수도 dev와 비슷한 0.8068로 마무리했습니다.
진로 취업 상담 챗봇 적용
Connect의 진로 상담 챗봇은 학생의 학적, 적성검사, 교과·비교과, 졸업생 취업 데이터를 연동해 전공 선택과 진로, 취업 상담에 답합니다. 자세한 내용은 진로 상담 챗봇은 학사 AI 챗봇과 무엇이 다를까? 글에서 소개했습니다.
여기서 한 단계 더 나아가면 학생과 기업의 채용공고를 매칭하는 문제를 만나게 됩니다. 한쪽에는 학생이 하고 싶은 것, 꿈, 성적, 장학, 비교과, 적성검사 결과 같은 개인화 데이터가 있고, 다른 쪽에는 여러 기업의 JD가 있습니다.
이 문제는 Task A와 구조가 같습니다. 학생 데이터는 성적표, 활동 기록, 검사 결과처럼 형식이 제각각이고, JD와 겹치는 단어도 거의 없습니다. 그대로 비교하면 대회에서 본 것과 같은 문제가 생깁니다.
따라서 대회에서 쓴 방법을 바로 적용해볼 수 있습니다. 학생 데이터와 JD를 LLM으로 같은 틀의 프로필(스킬, 경험, 관심 분야)로 확장한 뒤 매칭하는 방식입니다. Task B의 방법은 학생이 관심 있는 직무에 어떤 스킬이 필요한지 찾고, 이를 교과·비교과 추천으로 연결하는 데 쓸 수 있습니다. CLASSUM은 이 기술을 Connect의 진로 취업 상담에 적용할 예정입니다.
Conclusion
Task A는 평균 MAP 0.7140, Task B는 graded NDCG 0.8068로 두 태스크 모두 1위를 했습니다. Task A의 cross-lingual 평가(MAP 0.7044)에서도 1위였습니다.
두 태스크는 입력도 지표도 달랐지만, 비교하기 전에 LLM으로 양쪽을 확장하는 방법이 공통으로 효과가 있었습니다. 학생 데이터와 JD를 매칭하는 문제에서도 같은 효과가 있을 것이라고 생각됩니다.
Reference
- Gasco et al., "Overview of the TalentCLEF 2026: Skill and Job Title Intelligence for Human Capital Management", arXiv:2606.31692
- Kim, Choi, Lee, "Semantic Enrichment for Resume Ranking and Skill Retrieval at TalentCLEF 2026", CLEF 2026 Working Notes, CEUR-WS Vol-4283, https://ceur-ws.org/Vol-4283/paper481.pdf
안녕하세요, CLASSUM에서 기술개발총괄을 맡고있는 김상근(Windy)입니다.
CLASSUM은 대학과 기업을 위한 학습 플랫폼 Learning과 학사/입학/진로 취업 상담 AI 챗봇 Connect를 만들고 있습니다. 이 글에서는 올해 참가한 TalentCLEF 2026 대회의 소개와, 두 태스크를 풀면서 만난 문제 및 해결방법에 대해 공유하려고 합니다. 이 기술을 진로 취업 상담 챗봇에 어떻게 적용할 수 있는지도 같이 알아봅니다.
대회 결과
Task A, Task B 두 태스크 모두 1위를 했습니다.
우리 팀의 자세한 알고리즘은 CLEF 2026 Working Notes(CEUR-WS Vol-4283)에 실렸습니다.
TalentCLEF 2026
TalentCLEF는 채용, 직무, 스킬 같은 HR 분야의 자연어처리 문제를 다루는 대회로, CLEF 2026의 Lab으로 열렸습니다. 올해가 두 번째이고, 113팀이 등록해 400건이 넘는 제출이 있었습니다. 대회 초반에 정답이 있는 dev dataset이 주어지고, 대회 후반에 정답이 없는 test dataset이 공개됩니다.
Task A: 직무-이력서 매칭
채용공고(JD) 하나가 주어지면 이력서 N개를 적합한 순서로 정렬하는 문제입니다. 영어와 스페인어가 있고, 영어 공고로 스페인어 이력서를 찾는 cross-lingual 태스크도 따로 평가합니다. 평가 지표는 MAP입니다.
MAP (Mean Average Precision): 쿼리마다 관련 문서가 나올 때마다의 정밀도를 평균(AP)하고, 이것을 전체 쿼리에 대해 다시 평균한 값으로, 관련 문서를 얼마나 앞쪽에 모아 두었는지를 이진 관련성 기준으로 봅니다.
Task B: 직무-스킬 매칭
"logistics business analyst" 같은 직무명이 주어지면, 유럽의 직무·스킬 분류 체계인 ESCO의 스킬 수천 개 중 관련 있는 것을 찾아 정렬하는 문제입니다. 그 직무에 꼭 필요한 Core 스킬을 상황에 따라 필요한 Contextual 스킬보다 앞 순위에 정렬할수록 좋은 점수를 받습니다. 평가 지표는 graded NDCG입니다. Task A와 달리 학습 데이터가 주어집니다.
nDCG (normalized Discounted Cumulative Gain): 등급형 관련도 점수를 순위가 내려갈수록 로그로 깎아 합산(DCG)한 뒤, 이상적인 순서일 때의 값(IDCG)으로 나눠 0~1로 정규화한 지표입니다.
Problem
dev dataset을 받고 가장 먼저 원문을 그대로 임베딩한 뒤 코사인 유사도로 정렬해 채점해봤습니다. 두 태스크 모두 결과가 좋지 않았고, 원인은 서로 달랐습니다.
Task A는 채용공고(JD)와 이력서를 JobBERT-v3 모델로 임베딩했고, dev MAP이 0.7281이었습니다. 겉으로 겹치는 단어가 문제였습니다. “Healthcare Data Analyst” 공고와 “Electrical Engineer” 이력서는 engineering, data, systems 같은 단어를 공유하지만 하는 일은 전혀 다릅니다.
Task B는 직무명과 스킬을 MiniLM-L6-v2 모델로 임베딩했고, dev graded NDCG가 0.6107이었습니다. 여기서는 반대로 입력이 너무 짧은 것이 문제였습니다. 직무명은 두세 단어이고 스킬 이름도 한 줄이라 겹칠 것이 거의 없습니다.
또한 이 대회는 리더보드가 비공개였습니다. 제출해도 다른 팀의 점수를 볼 수 없고 완벽한 블라인드 상태에서 대회를 진행하다 보니, 우리 팀의 실험 결과가 어느 정도 위치에 있는지 알 수 없다는 문제도 있었습니다. (대회 기간 내내 쫓기는 듯한 느낌을 받았습니다.)
Solution, Task A: 직무-이력서 매칭
Approach 1. 원문 임베딩
임베딩 모델을 더 크고 성능이 좋은 범용 모델로 바꾸자 모델 하나만으로도 dev MAP이 0.90 정도 나왔습니다. 하지만 단어만 겹치는 이력서가 상위에 올라오는 문제가 있었고, 임베딩 모델을 다양하게 실험해봐도 점수가 더 오르지 않았습니다.
Approach 2. LLM을 이용한 프로필 확장
공고와 이력서를 LLM을 활용하여 같은 구조에 맞춰 다시 썼습니다. 직함, 연차, 도메인, 세부 분야, 요약을 뽑고, 스킬(할 수 있는 것)과 업무(실제로 한 것)를 나눠 추출했습니다. 스킬은 다시 그 직무에 특화된 것과 다른 직무에도 통하는 것으로 구분했습니다.
이렇게 하면 그림 6의 “Healthcare Data Analyst” 공고와 “Electrical Engineer” 이력서는 도메인 항목에서 “Healthcare / Data Analytics”와 “Electrical Engineering”으로 바로 구분됩니다. 확장한 프로필은 전체를 임베딩하기도 하고, 직함만 또는 업무 목록만 따로 임베딩하기도 했습니다.
Approach 3. 모델 앙상블
단일 모델로는 한계가 있어서 성격이 다른 채점 모델을 18개 정도 만들었습니다.
- 원문 임베딩 (Nemotron-8B, KaLM-12B, ZEmbed-1 등)
- 확장한 프로필 임베딩 (Gemini embedding)
- LLM에게 이력서를 한꺼번에 주고 순위를 매기게 하는 listwise 채점 (GPT-5.5, Claude Opus 4.6)
- 직함, 연차, 직능, 도메인 네 차원으로 점수를 매기는 루브릭 채점 (Gemini 3 Flash)
각 모델의 점수는 공고 단위로 0~1 사이로 정규화한 뒤 더했습니다. 성능이 좋은 모델에 가중치를 더 주는 방법(선형, 제곱, 세제곱, 지수, 순위 기반)도 해봤지만, 전부 가중치를 똑같이 준 것보다 낮았습니다. 이 접근으로 dev MAP 0.9339점을 얻었습니다.
Approach 4. dev 정답 기반 매칭 기준 추출
dev dataset의 정답은 사람이 직접 검수한 것입니다. 그래서 공고마다 정답 이력서와, 비슷해 보이지만 오답인 이력서를 묶어 LLM에게 주고 채점자의 판단 기준을 정리하게 했습니다.
처음에는 "계산원은 판매직에 합격" 같이 특정 직무명에 묶인 규칙이 나와서 쓸 수가 없었습니다. 직무명 대신 일의 종류로 쓰도록 프롬프트를 변경한 뒤에는 "같은 도구를 써도 그 도구로 하는 일이 다르면 맞지 않는다" 같은 기준이 나왔고, 이를 listwise 채점과 루브릭 채점의 지시문에 넣었습니다. 이 접근으로 dev MAP 0.9368점을 얻었습니다.
Approach 5. 앙상블 조합 선택
실험 결과는 전부 파일로 저장해 두었기 때문에, 모델 18개로 만들 수 있는 약 26만 개의 조합을 계산만으로 비교할 수 있었습니다. 문제는 기준이었습니다. dev 점수가 가장 높은 조합을 고르면 dev에만 맞춰질 위험이 컸습니다. 실제로 dev MAP 0.93대 조합의 첫 test 제출 점수는 0.69였습니다.
그래서 기준을 하나 더 만들었습니다. 사내에서 쓰던 스킬/업무 추출 파이프라인으로 공고와 이력서의 프로필을 만들고, 프로필이 겹치는 정도로 내부 평가용 정답 셋을 만들었습니다. 그리고 dev 점수와 내부 정답 셋 점수 중 낮은 쪽이 가장 높은 조합을 골랐습니다. 세부 태스크인 언어 설정(영어-영어, 스페인어-스페인어, 영어-스페인어)마다 조합도 따로 골랐습니다.
Approach 6. 후처리
test dataset을 직접 읽어 보니 같은 역할의 이력서가 표현만 바뀌어 여러 개 들어 있었습니다. 따라서 같은 역할로 묶이는 이력서끼리 점수를 평균 내어 다시 나눠 주었습니다.
또한 합친 점수를 정렬해 보면 점수가 거의 같은 이력서들이 모여 plateau를 이룹니다. 이 plateau를 찾은 뒤, 각 plateau 안에서만 reranker(zerank-2)로 순서를 다시 정했습니다. plateau 사이의 순서는 바꾸지 않았고, 이 접근으로 최종 test MAP 0.7140점을 받았습니다.
Algorithm pseudo code
function rank(jd, cvs, lang):
  scores := []
  for scorer in SELECTED[lang]:                 # Approach 5
    s := scorer.score(enrich(jd), enrich(cvs))  # Approach 2, 4
    scores.push(minmax(s))                      # 공고 단위 정규화
  fused := sum(scores)                          # Approach 3
  fused := smoothByRole(fused, cvs)             # Approach 6
  fused := rerankWithinPlateau(fused)           # Approach 6
  return sortBy(cvs, fused)
Bias 평가
Task A는 성별 편향도 따로 평가합니다. 이름과 직함의 성별 표현만 바꾼 이력서를 넣었을 때 순위가 얼마나 유지되는지를 RBO로 측정합니다.
RBO (Rank-Biased Overlap): 두 순위 리스트가 각 깊이에서 얼마나 겹치는지를 상위에 더 큰 가중치(파라미터 p)를 두고 합산한 유사도로, 정답 없이 두 랭킹이 서로 얼마나 비슷한지 비교할 때 씁니다.
평균 RBO 0.9904로 이 평가에서도 1위였습니다(2위 0.9547). 편향을 줄이는 장치를 따로 넣지는 않았는데, 주최 측은 스킬과 업무 중심으로 프로필을 확장하면서 이름이나 성별 표현의 영향이 줄었을 것이라고 해석했습니다.
Solution, Task B: 직무-스킬 매칭
Approach 1. 직무명과 스킬 확장
Task A와 같은 생각으로, 직무명과 스킬을 둘 다 확장했습니다. 직무명은 LLM으로 그 직무가 하는 업무와 필요한 스킬 목록으로 확장했습니다. 스킬은 ESCO에 있는 정보(다른 이름, 설명, 상위 개념, 연결된 직업)를 붙여 스킬마다 카드를 만들었습니다.
아래는 같은 임베딩 모델에서 입력만 바꿔 비교한 결과입니다.
직무명스킬graded NDCG원문원문0.6745원문스킬 카드0.7094확장한 프로필스킬 카드0.7555
Approach 2. 임베딩 모델 파인튜닝
Task B는 학습 데이터가 있어서 오픈웨이트 임베딩 모델 네 개(ZEmbed-1, KaLM-Embedding-Gemma3-12B, Qwen3-Embedding-8B, Llama-NV-Embed-Reasoning-3B)를 파인튜닝했습니다.
여기서 문제는 오답 처리였습니다. Contrastive learning은 같은 배치 안의 다른 스킬을 오답으로 취급하는데, ESCO 스킬은 서로 비슷한 것이 많아서 오답으로 처리된 스킬이 사실은 정답에 가까운 경우가 많았습니다. 그래서 먼저 학습한 모델을 guide로 두고, guide가 보기에 정답과 점수 차이가 거의 없는 후보는 오답에서 제외하고 학습했습니다. 이 접근으로 모델별 dev graded NDCG 0.7792 ~ 0.7894가 나왔습니다.
Approach 3. 앙상블과 reranking
네 모델의 점수를 가중합으로 합쳤습니다. 가중치는 dev dataset에서 Optuna로 탐색했습니다. 마지막으로 상위 512개를 zerank-2로 rerank한 뒤 원래 점수와 절반씩 섞었고, dev graded NDCG 0.8078 점수를 얻었습니다.
Task B는 test 점수도 dev와 비슷한 0.8068로 마무리했습니다.
진로 취업 상담 챗봇 적용
Connect의 진로 상담 챗봇은 학생의 학적, 적성검사, 교과·비교과, 졸업생 취업 데이터를 연동해 전공 선택과 진로, 취업 상담에 답합니다. 자세한 내용은 진로 상담 챗봇은 학사 AI 챗봇과 무엇이 다를까? 글에서 소개했습니다.
여기서 한 단계 더 나아가면 학생과 기업의 채용공고를 매칭하는 문제를 만나게 됩니다. 한쪽에는 학생이 하고 싶은 것, 꿈, 성적, 장학, 비교과, 적성검사 결과 같은 개인화 데이터가 있고, 다른 쪽에는 여러 기업의 JD가 있습니다.
이 문제는 Task A와 구조가 같습니다. 학생 데이터는 성적표, 활동 기록, 검사 결과처럼 형식이 제각각이고, JD와 겹치는 단어도 거의 없습니다. 그대로 비교하면 대회에서 본 것과 같은 문제가 생깁니다.
따라서 대회에서 쓴 방법을 바로 적용해볼 수 있습니다. 학생 데이터와 JD를 LLM으로 같은 틀의 프로필(스킬, 경험, 관심 분야)로 확장한 뒤 매칭하는 방식입니다. Task B의 방법은 학생이 관심 있는 직무에 어떤 스킬이 필요한지 찾고, 이를 교과·비교과 추천으로 연결하는 데 쓸 수 있습니다. CLASSUM은 이 기술을 Connect의 진로 취업 상담에 적용할 예정입니다.
Conclusion
Task A는 평균 MAP 0.7140, Task B는 graded NDCG 0.8068로 두 태스크 모두 1위를 했습니다. Task A의 cross-lingual 평가(MAP 0.7044)에서도 1위였습니다.
두 태스크는 입력도 지표도 달랐지만, 비교하기 전에 LLM으로 양쪽을 확장하는 방법이 공통으로 효과가 있었습니다. 학생 데이터와 JD를 매칭하는 문제에서도 같은 효과가 있을 것이라고 생각됩니다.
Reference
- Gasco et al., "Overview of the TalentCLEF 2026: Skill and Job Title Intelligence for Human Capital Management", arXiv:2606.31692
- Kim, Choi, Lee, "Semantic Enrichment for Resume Ranking and Skill Retrieval at TalentCLEF 2026", CLEF 2026 Working Notes, CEUR-WS Vol-4283, https://ceur-ws.org/Vol-4283/paper481.pdf
안녕하세요, CLASSUM에서 기술개발총괄을 맡고있는 김상근(Windy)입니다.
CLASSUM은 대학과 기업을 위한 학습 플랫폼 Learning과 학사/입학/진로 취업 상담 AI 챗봇 Connect를 만들고 있습니다. 이 글에서는 올해 참가한 TalentCLEF 2026 대회의 소개와, 두 태스크를 풀면서 만난 문제 및 해결방법에 대해 공유하려고 합니다. 이 기술을 진로 취업 상담 챗봇에 어떻게 적용할 수 있는지도 같이 알아봅니다.
대회 결과
Task A, Task B 두 태스크 모두 1위를 했습니다.
우리 팀의 자세한 알고리즘은 CLEF 2026 Working Notes(CEUR-WS Vol-4283)에 실렸습니다.
TalentCLEF 2026
TalentCLEF는 채용, 직무, 스킬 같은 HR 분야의 자연어처리 문제를 다루는 대회로, CLEF 2026의 Lab으로 열렸습니다. 올해가 두 번째이고, 113팀이 등록해 400건이 넘는 제출이 있었습니다. 대회 초반에 정답이 있는 dev dataset이 주어지고, 대회 후반에 정답이 없는 test dataset이 공개됩니다.
Task A: 직무-이력서 매칭
채용공고(JD) 하나가 주어지면 이력서 N개를 적합한 순서로 정렬하는 문제입니다. 영어와 스페인어가 있고, 영어 공고로 스페인어 이력서를 찾는 cross-lingual 태스크도 따로 평가합니다. 평가 지표는 MAP입니다.
MAP (Mean Average Precision): 쿼리마다 관련 문서가 나올 때마다의 정밀도를 평균(AP)하고, 이것을 전체 쿼리에 대해 다시 평균한 값으로, 관련 문서를 얼마나 앞쪽에 모아 두었는지를 이진 관련성 기준으로 봅니다.
Task B: 직무-스킬 매칭
"logistics business analyst" 같은 직무명이 주어지면, 유럽의 직무·스킬 분류 체계인 ESCO의 스킬 수천 개 중 관련 있는 것을 찾아 정렬하는 문제입니다. 그 직무에 꼭 필요한 Core 스킬을 상황에 따라 필요한 Contextual 스킬보다 앞 순위에 정렬할수록 좋은 점수를 받습니다. 평가 지표는 graded NDCG입니다. Task A와 달리 학습 데이터가 주어집니다.
nDCG (normalized Discounted Cumulative Gain): 등급형 관련도 점수를 순위가 내려갈수록 로그로 깎아 합산(DCG)한 뒤, 이상적인 순서일 때의 값(IDCG)으로 나눠 0~1로 정규화한 지표입니다.
Problem
dev dataset을 받고 가장 먼저 원문을 그대로 임베딩한 뒤 코사인 유사도로 정렬해 채점해봤습니다. 두 태스크 모두 결과가 좋지 않았고, 원인은 서로 달랐습니다.
Task A는 채용공고(JD)와 이력서를 JobBERT-v3 모델로 임베딩했고, dev MAP이 0.7281이었습니다. 겉으로 겹치는 단어가 문제였습니다. “Healthcare Data Analyst” 공고와 “Electrical Engineer” 이력서는 engineering, data, systems 같은 단어를 공유하지만 하는 일은 전혀 다릅니다.
Task B는 직무명과 스킬을 MiniLM-L6-v2 모델로 임베딩했고, dev graded NDCG가 0.6107이었습니다. 여기서는 반대로 입력이 너무 짧은 것이 문제였습니다. 직무명은 두세 단어이고 스킬 이름도 한 줄이라 겹칠 것이 거의 없습니다.
또한 이 대회는 리더보드가 비공개였습니다. 제출해도 다른 팀의 점수를 볼 수 없고 완벽한 블라인드 상태에서 대회를 진행하다 보니, 우리 팀의 실험 결과가 어느 정도 위치에 있는지 알 수 없다는 문제도 있었습니다. (대회 기간 내내 쫓기는 듯한 느낌을 받았습니다.)
Solution, Task A: 직무-이력서 매칭
Approach 1. 원문 임베딩
임베딩 모델을 더 크고 성능이 좋은 범용 모델로 바꾸자 모델 하나만으로도 dev MAP이 0.90 정도 나왔습니다. 하지만 단어만 겹치는 이력서가 상위에 올라오는 문제가 있었고, 임베딩 모델을 다양하게 실험해봐도 점수가 더 오르지 않았습니다.
Approach 2. LLM을 이용한 프로필 확장
공고와 이력서를 LLM을 활용하여 같은 구조에 맞춰 다시 썼습니다. 직함, 연차, 도메인, 세부 분야, 요약을 뽑고, 스킬(할 수 있는 것)과 업무(실제로 한 것)를 나눠 추출했습니다. 스킬은 다시 그 직무에 특화된 것과 다른 직무에도 통하는 것으로 구분했습니다.
이렇게 하면 그림 6의 “Healthcare Data Analyst” 공고와 “Electrical Engineer” 이력서는 도메인 항목에서 “Healthcare / Data Analytics”와 “Electrical Engineering”으로 바로 구분됩니다. 확장한 프로필은 전체를 임베딩하기도 하고, 직함만 또는 업무 목록만 따로 임베딩하기도 했습니다.
Approach 3. 모델 앙상블
단일 모델로는 한계가 있어서 성격이 다른 채점 모델을 18개 정도 만들었습니다.
- 원문 임베딩 (Nemotron-8B, KaLM-12B, ZEmbed-1 등)
- 확장한 프로필 임베딩 (Gemini embedding)
- LLM에게 이력서를 한꺼번에 주고 순위를 매기게 하는 listwise 채점 (GPT-5.5, Claude Opus 4.6)
- 직함, 연차, 직능, 도메인 네 차원으로 점수를 매기는 루브릭 채점 (Gemini 3 Flash)
각 모델의 점수는 공고 단위로 0~1 사이로 정규화한 뒤 더했습니다. 성능이 좋은 모델에 가중치를 더 주는 방법(선형, 제곱, 세제곱, 지수, 순위 기반)도 해봤지만, 전부 가중치를 똑같이 준 것보다 낮았습니다. 이 접근으로 dev MAP 0.9339점을 얻었습니다.
Approach 4. dev 정답 기반 매칭 기준 추출
dev dataset의 정답은 사람이 직접 검수한 것입니다. 그래서 공고마다 정답 이력서와, 비슷해 보이지만 오답인 이력서를 묶어 LLM에게 주고 채점자의 판단 기준을 정리하게 했습니다.
처음에는 "계산원은 판매직에 합격" 같이 특정 직무명에 묶인 규칙이 나와서 쓸 수가 없었습니다. 직무명 대신 일의 종류로 쓰도록 프롬프트를 변경한 뒤에는 "같은 도구를 써도 그 도구로 하는 일이 다르면 맞지 않는다" 같은 기준이 나왔고, 이를 listwise 채점과 루브릭 채점의 지시문에 넣었습니다. 이 접근으로 dev MAP 0.9368점을 얻었습니다.
Approach 5. 앙상블 조합 선택
실험 결과는 전부 파일로 저장해 두었기 때문에, 모델 18개로 만들 수 있는 약 26만 개의 조합을 계산만으로 비교할 수 있었습니다. 문제는 기준이었습니다. dev 점수가 가장 높은 조합을 고르면 dev에만 맞춰질 위험이 컸습니다. 실제로 dev MAP 0.93대 조합의 첫 test 제출 점수는 0.69였습니다.
그래서 기준을 하나 더 만들었습니다. 사내에서 쓰던 스킬/업무 추출 파이프라인으로 공고와 이력서의 프로필을 만들고, 프로필이 겹치는 정도로 내부 평가용 정답 셋을 만들었습니다. 그리고 dev 점수와 내부 정답 셋 점수 중 낮은 쪽이 가장 높은 조합을 골랐습니다. 세부 태스크인 언어 설정(영어-영어, 스페인어-스페인어, 영어-스페인어)마다 조합도 따로 골랐습니다.
Approach 6. 후처리
test dataset을 직접 읽어 보니 같은 역할의 이력서가 표현만 바뀌어 여러 개 들어 있었습니다. 따라서 같은 역할로 묶이는 이력서끼리 점수를 평균 내어 다시 나눠 주었습니다.
또한 합친 점수를 정렬해 보면 점수가 거의 같은 이력서들이 모여 plateau를 이룹니다. 이 plateau를 찾은 뒤, 각 plateau 안에서만 reranker(zerank-2)로 순서를 다시 정했습니다. plateau 사이의 순서는 바꾸지 않았고, 이 접근으로 최종 test MAP 0.7140점을 받았습니다.
Algorithm pseudo code
function rank(jd, cvs, lang):
  scores := []
  for scorer in SELECTED[lang]:                 # Approach 5
    s := scorer.score(enrich(jd), enrich(cvs))  # Approach 2, 4
    scores.push(minmax(s))                      # 공고 단위 정규화
  fused := sum(scores)                          # Approach 3
  fused := smoothByRole(fused, cvs)             # Approach 6
  fused := rerankWithinPlateau(fused)           # Approach 6
  return sortBy(cvs, fused)
Bias 평가
Task A는 성별 편향도 따로 평가합니다. 이름과 직함의 성별 표현만 바꾼 이력서를 넣었을 때 순위가 얼마나 유지되는지를 RBO로 측정합니다.
RBO (Rank-Biased Overlap): 두 순위 리스트가 각 깊이에서 얼마나 겹치는지를 상위에 더 큰 가중치(파라미터 p)를 두고 합산한 유사도로, 정답 없이 두 랭킹이 서로 얼마나 비슷한지 비교할 때 씁니다.
평균 RBO 0.9904로 이 평가에서도 1위였습니다(2위 0.9547). 편향을 줄이는 장치를 따로 넣지는 않았는데, 주최 측은 스킬과 업무 중심으로 프로필을 확장하면서 이름이나 성별 표현의 영향이 줄었을 것이라고 해석했습니다.
Solution, Task B: 직무-스킬 매칭
Approach 1. 직무명과 스킬 확장
Task A와 같은 생각으로, 직무명과 스킬을 둘 다 확장했습니다. 직무명은 LLM으로 그 직무가 하는 업무와 필요한 스킬 목록으로 확장했습니다. 스킬은 ESCO에 있는 정보(다른 이름, 설명, 상위 개념, 연결된 직업)를 붙여 스킬마다 카드를 만들었습니다.
아래는 같은 임베딩 모델에서 입력만 바꿔 비교한 결과입니다.
직무명스킬graded NDCG원문원문0.6745원문스킬 카드0.7094확장한 프로필스킬 카드0.7555
Approach 2. 임베딩 모델 파인튜닝
Task B는 학습 데이터가 있어서 오픈웨이트 임베딩 모델 네 개(ZEmbed-1, KaLM-Embedding-Gemma3-12B, Qwen3-Embedding-8B, Llama-NV-Embed-Reasoning-3B)를 파인튜닝했습니다.
여기서 문제는 오답 처리였습니다. Contrastive learning은 같은 배치 안의 다른 스킬을 오답으로 취급하는데, ESCO 스킬은 서로 비슷한 것이 많아서 오답으로 처리된 스킬이 사실은 정답에 가까운 경우가 많았습니다. 그래서 먼저 학습한 모델을 guide로 두고, guide가 보기에 정답과 점수 차이가 거의 없는 후보는 오답에서 제외하고 학습했습니다. 이 접근으로 모델별 dev graded NDCG 0.7792 ~ 0.7894가 나왔습니다.
Approach 3. 앙상블과 reranking
네 모델의 점수를 가중합으로 합쳤습니다. 가중치는 dev dataset에서 Optuna로 탐색했습니다. 마지막으로 상위 512개를 zerank-2로 rerank한 뒤 원래 점수와 절반씩 섞었고, dev graded NDCG 0.8078 점수를 얻었습니다.
Task B는 test 점수도 dev와 비슷한 0.8068로 마무리했습니다.
진로 취업 상담 챗봇 적용
Connect의 진로 상담 챗봇은 학생의 학적, 적성검사, 교과·비교과, 졸업생 취업 데이터를 연동해 전공 선택과 진로, 취업 상담에 답합니다. 자세한 내용은 진로 상담 챗봇은 학사 AI 챗봇과 무엇이 다를까? 글에서 소개했습니다.
여기서 한 단계 더 나아가면 학생과 기업의 채용공고를 매칭하는 문제를 만나게 됩니다. 한쪽에는 학생이 하고 싶은 것, 꿈, 성적, 장학, 비교과, 적성검사 결과 같은 개인화 데이터가 있고, 다른 쪽에는 여러 기업의 JD가 있습니다.
이 문제는 Task A와 구조가 같습니다. 학생 데이터는 성적표, 활동 기록, 검사 결과처럼 형식이 제각각이고, JD와 겹치는 단어도 거의 없습니다. 그대로 비교하면 대회에서 본 것과 같은 문제가 생깁니다.
따라서 대회에서 쓴 방법을 바로 적용해볼 수 있습니다. 학생 데이터와 JD를 LLM으로 같은 틀의 프로필(스킬, 경험, 관심 분야)로 확장한 뒤 매칭하는 방식입니다. Task B의 방법은 학생이 관심 있는 직무에 어떤 스킬이 필요한지 찾고, 이를 교과·비교과 추천으로 연결하는 데 쓸 수 있습니다. CLASSUM은 이 기술을 Connect의 진로 취업 상담에 적용할 예정입니다.
Conclusion
Task A는 평균 MAP 0.7140, Task B는 graded NDCG 0.8068로 두 태스크 모두 1위를 했습니다. Task A의 cross-lingual 평가(MAP 0.7044)에서도 1위였습니다.
두 태스크는 입력도 지표도 달랐지만, 비교하기 전에 LLM으로 양쪽을 확장하는 방법이 공통으로 효과가 있었습니다. 학생 데이터와 JD를 매칭하는 문제에서도 같은 효과가 있을 것이라고 생각됩니다.
Reference
- Gasco et al., "Overview of the TalentCLEF 2026: Skill and Job Title Intelligence for Human Capital Management", arXiv:2606.31692
- Kim, Choi, Lee, "Semantic Enrichment for Resume Ranking and Skill Retrieval at TalentCLEF 2026", CLEF 2026 Working Notes, CEUR-WS Vol-4283, https://ceur-ws.org/Vol-4283/paper481.pdf